Durchsuchbare PDF-Exporte mit OCR
Eine eingebettete OCR-Textebene macht exportierte PDFs durchsuchbar und berücksichtigt bei der Platzierung das Seitenlayout.
Mit der integrierten OCR werden PDF-Exporte aus Screenshots durchsuchbar.
Durchsuchbare PDF-Exporte
- Eingebettete Textebene zum Suchen und Auswählen von Text.
- Tagged-PDF-Ausgabe für bessere Barrierefreiheit.
- Layoutabhängige OCR-Platzierung für mehrspaltige Seiten.
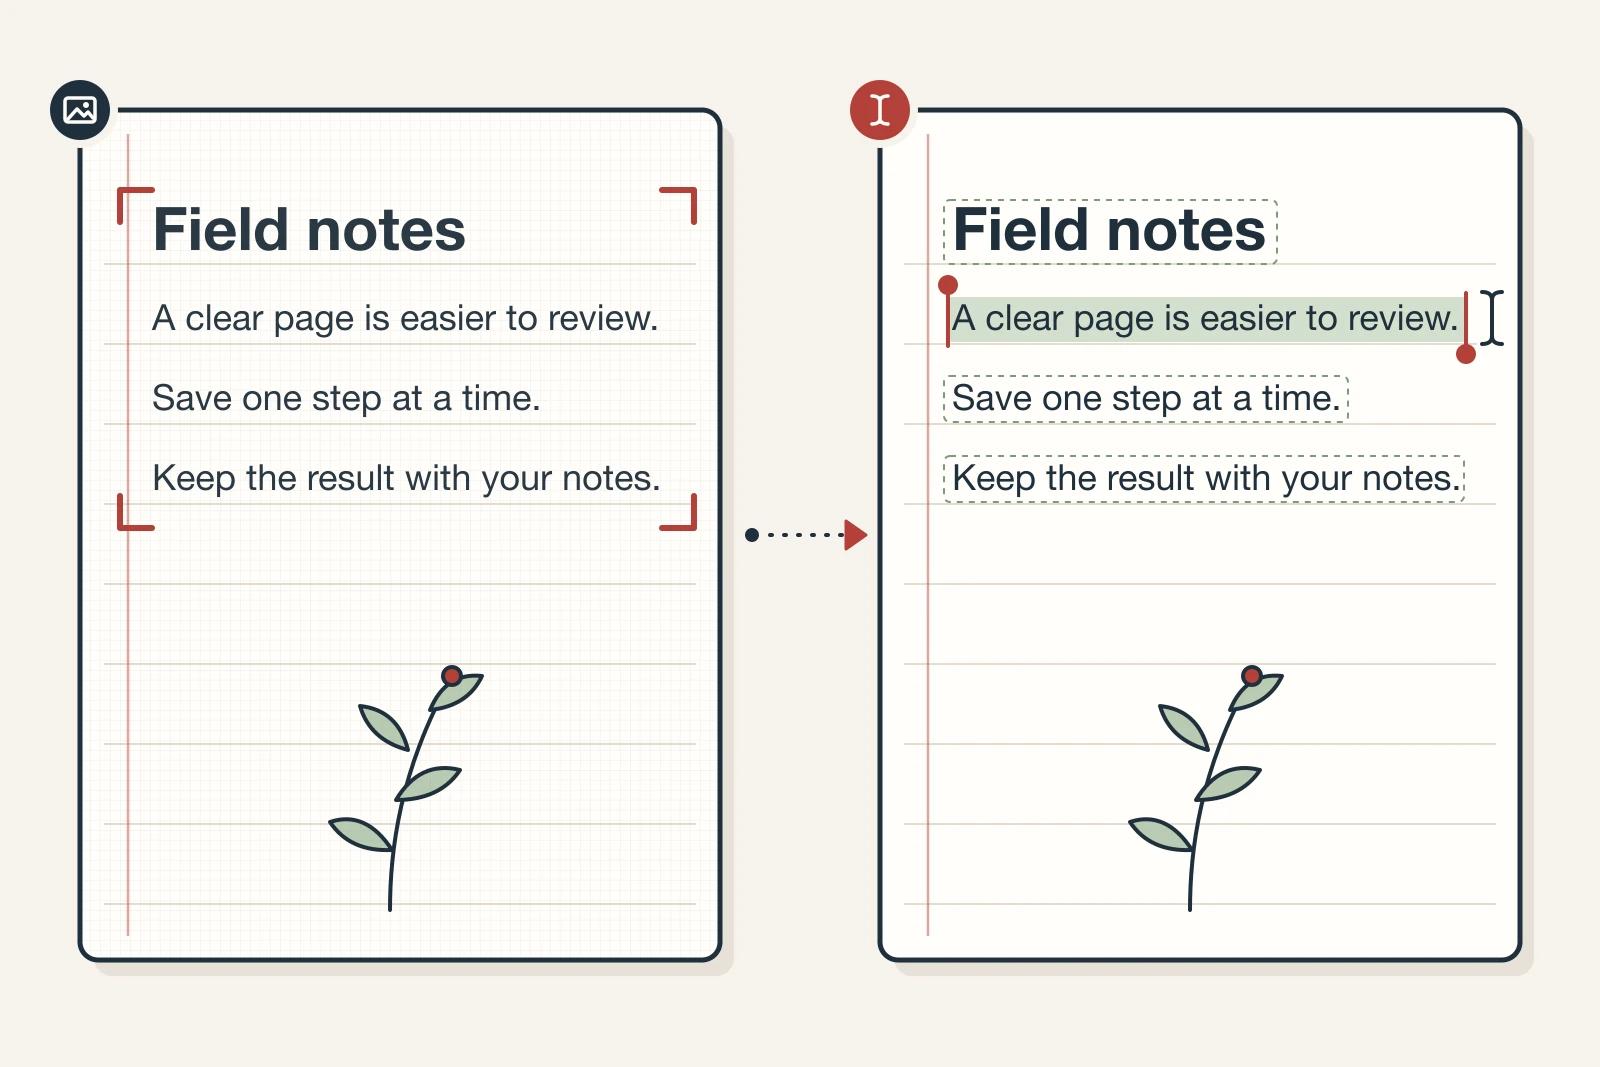
Schaubild mit selbst verfasstem Beispieltext: Eine OCR-Ebene macht den Text im Bild auswählbar.
So entsteht die OCR-Ebene
Die Texterkennung läuft beim PDF-Export automatisch. Du musst keine zusätzliche Option einschalten und deinen Ablauf nicht ändern.
Im Hintergrund passiert Folgendes:
- Tesseract.js läuft lokal mit gebündelten Sprachdaten.
- Shotomatic wertet Begrenzungsrahmen für Wörter, Zeilen und Blöcke aus, um Spalten und Lesereihenfolge zu erkennen.
- Jedes Wort wird auf die Koordinaten im fertigen PDF skaliert und als unsichtbare Textebene eingefügt.
- Ist der Tagged-PDF-Modus aktiv, gruppiert Shotomatic Wörter zu Absätzen und hinterlegt
ActualTextfür assistive Technologien.
Aktualisiere Shotomatic auf Version 1.6.0, um durchsuchbare PDFs mit OCR zu exportieren.
Ähnliche Funktionen und Updates
Ähnliche Funktionen
Screenshots als PDF oder animiertes GIF exportieren
Verwandle eine Screenshot-Sitzung in ein PDF für Dokumentationen oder in ein animiertes GIF für Anleitungen, Fehlerberichte und Demos.
Mehrere Screenshots über Vorschaubilder verwalten
In der Seitenleiste kannst du mehrere Screenshots ansehen, sortieren, auswählen und gemeinsam exportieren.
Shotomatic 1.9.9: 3-Tage-Pass
Shotomatic 1.9.9 bringt einen 3-Tage-Pass für einzelne Projekte und ändert die Limits der kostenlosen Auto Capture auf 3 Screenshots pro Durchlauf und 9 pro Tag.
Bereit für einen einfacheren Screenshot-Ablauf?
Automatisiere wiederkehrende Aufnahmen und spare Zeit.