新功能
v1.6.0
Shotomatic Team
约 2 分钟阅读可搜索的 OCR PDF 导出
在 PDF 中嵌入 OCR 文本层,并按照版面定位,让导出的 PDF 可以搜索。
内置 OCR 可以把截图导出为可搜索的 PDF。
可搜索的 PDF 导出
- 嵌入文本层,支持搜索与选择
- 输出带标签的 PDF,改善无障碍访问
- 根据版面定位 OCR 内容,适配多栏页面
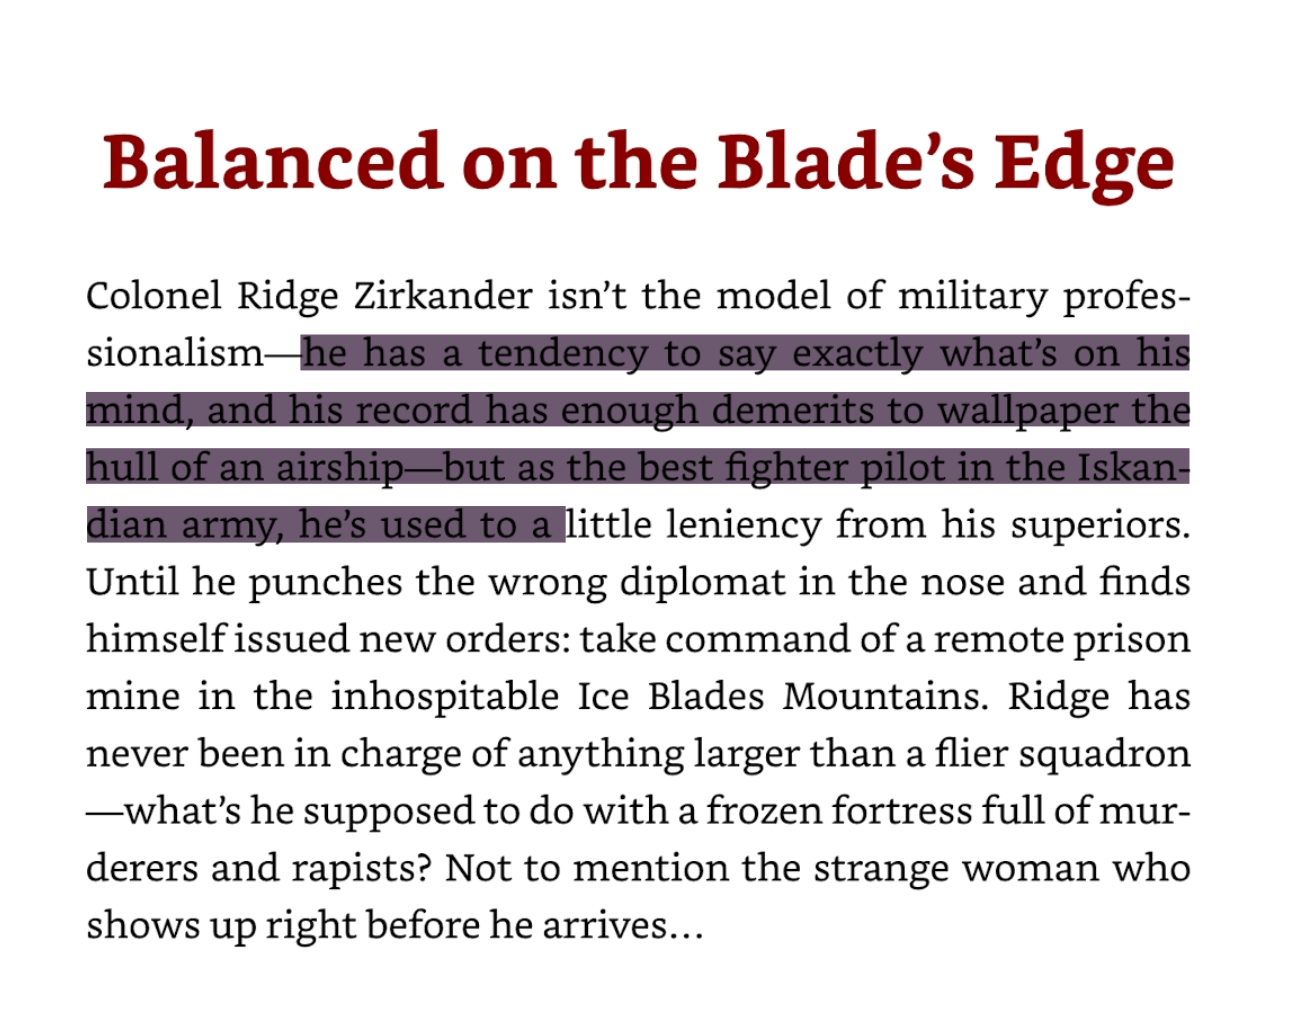
示例:直接在导出的 PDF 中拖动选择 OCR 文本。
OCR 文本层的生成方式
导出 PDF 时会自动运行 OCR。你无需启用选项,也不用改变现有流程。
具体流程如下:
- Tesseract.js 使用内置语言数据在本地运行。
- 我们提取词语边界框、行和文本块,用于推断分栏与阅读顺序。
- 每个词语会按最终 PDF 坐标缩放,并绘制为不可见文本层。
- 开启带标签 PDF 模式后,我们会将词语组合成段落,并附加 ActualText 以改善无障碍访问。
更新至 Shotomatic v1.6.0,使用 OCR 导出可搜索的 PDF。